“谜底,会越来越低廉。着实,则会越来越伏击。
假定这么一个场景。盘算会上,雇主问:“这个月利润为什么跌了?”
业务负责东谈主掏首先机,对着AI说了一句。十秒钟后,一张张漂亮的图表出目下屏幕上,AI用运动的谈话给出了三条归因:退款率飞腾、投放效劳着落、某渠谈费比相等。
雇主点点头,然后问了三个问题:
“这个数据是哪张表来的?”
“和上个月的口径一致吗?”
“谁有权看到这个明细?”
会议室清闲了。
这是夙昔两年,多数企业在尝试“对话式BI”和“Data Agent”之后,反复遇到的真实逆境。AI让“生成一张图”变得前所未有的容易,但企业很快发现,一张“看起来对”但本质上造作的图表,比莫得图表更危机。
大模子和Agent拆掉了BI的旧城墙,交互门槛、操作门槛、本领门槛,险些在整夜之间归零。但新地基还莫得打好,当AI成为分析的主体,口径、血统、权限、株连,这些传统BI花二十年建造起来的治理体系,霎时濒临一个狂暴的问题:AI要不要遵照?如何遵照?谁来保证?
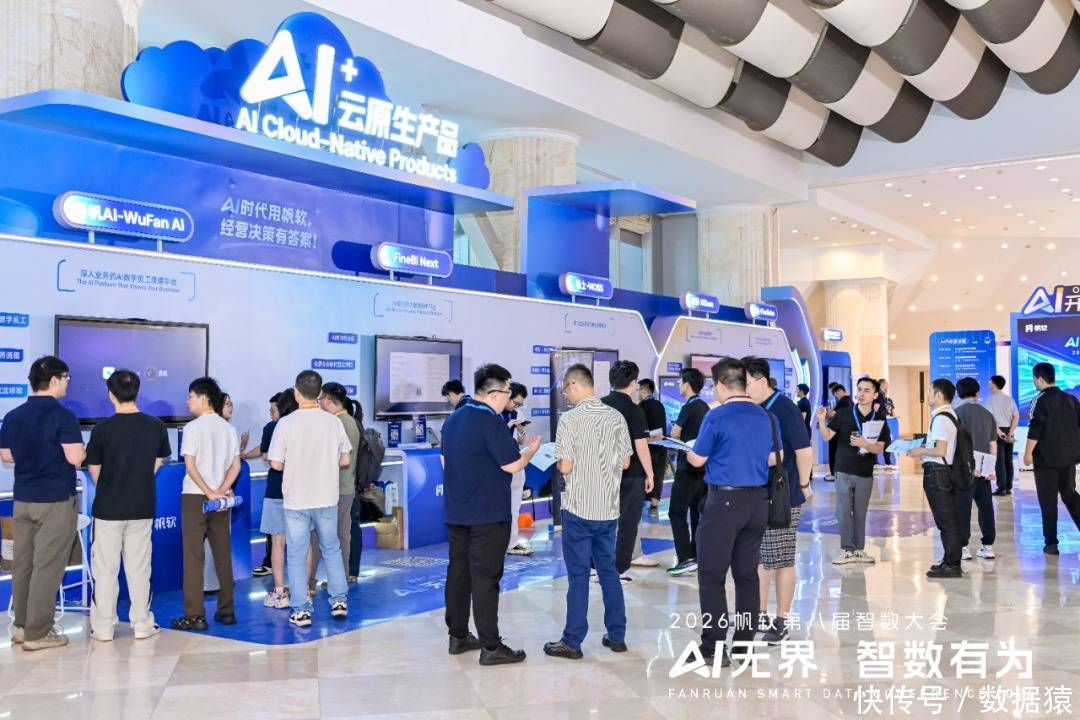
帆软举办的2026帆软第八届智数大会上,一系列产物尤其是FineBI Next的发布,试图给这些问题,找到一个谜底。
 吵杂背后的冷想考企业AI落大地临三个真问题
大模子和Agent来了之后,数据分析行业一度很昌盛。
似乎只消接上大模子,加上Python和ECharts,就能作念出一个“Data Agent”。用户发问,AI生成图表,致使能产出完竣的HTML分析页面。演示成果极好,客户看了王人说想要。
但企业很快发现了一个难过的现实,这些AI生成的分析,没东谈主敢用。
Agent数目在爆发,但企业着实要面对的问题,才刚刚运行。
夙昔一年,行业究诘的焦点从“AI能弗成作念分析”转向“AI作念的分析能弗成用”。这个转向背后,是三个越来越彰着的真问题。
问题一:当谜底造作时,AI倾向于把它包装得正确
也许,一份AI生成的盘算简报,标题完竣、趋势了了、提议专科,看起来新浪搬家。但要是把内部的数字逐条对回原始记载,许多时刻,问题就表露了。
从模子的特点来看,大模子被历炼就“非论如何王人要给出一个看起来完竣的谜底”,而不是“不细则时坦承不细则”。这个特点在聊天场景里是优点,在企业有盘算场景里是风险。
造作一朝被包装成“很对的谜底”,比莫得谜底更危机。因为它会让东谈主收缩警惕,平直插足有盘算链路。
问题二:口径比模子更容易出问题
要是说“数字对分歧”是AI分析的第一齐坎,那么“口径统不谐和”,是更遮蔽的第二谈坎。
大模子的武艺正在快速拘谨,吞并个模子在不同器具里的发挥各异越来越小。但口径问题正巧违反,它不仅取决于模子有多灵巧,还取决于模子外面的那层系统有莫得把法例管住。
这背后指向一个更深层的行业问题:夙昔几年,大模子公司忙着卷参数、卷武艺,但企业着实需要的,是把模子武艺管理在企业已有的数据治理体系里。
问题三:Agent越主动,造作越危机
数字对分歧、口径统不谐和,这两个问题还没惩办,行业依然在往下一个标的跑了:从“东谈主问AI答”走向“Agent主动推送风险”。
Agent独揽范围和权限王人在扩大,这自己是善事,它能24小时不雅察数据变化,主动发现问题。但它也带来了新的风险,要是推送的是一个未经校验的论断,造作就会从“被迫查询”升级为“主动触达”。
Agent裁减了“生成”的资本,却放大了“考据”的资本。当企业发现,考据AI输出的资本,比我方作念一遍还高时,这项本领就失去了插足坐褥环境的阅历。
为什么这些问题,行业一直惩办不了?
要惩办这些问题,需要一套能让AI的分析过程像企业BI相同可管理、可回想、可校验的基础要道。
但行业里,很少东谈主在作念这件事。
为什么?通用AI公司作念不了,它们没少见据分析领域的蕴蓄,莫得企业的盘算体系、权限体系和数据治理教养。许多BI厂商也很难作念,它们要么只作念BI,要么自后才补AI,莫得把两者着实会通。
这就引出一个更根底的问题:企业AI的竞争,到底在拼什么?
从BI到AI帆软用二十年完成一次“静默升级”在整个BI厂商中,帆软的聘任值得关心。
这家建树于2006年的公司,专注贸易智能和数据分析近20年。历久办事企业过程中蕴蓄的数据表露、业务教养和场景瓦解,恰正是通用AI公司最难复制的。
此外,一个容易被忽略的事实是:帆软不是霎时运行作念AI的。从2024年发布对话式BI产物FineChatBI,到2025年发布FineBI 7.0,再到2026年推出全场景AI智能体矩阵,节拍不算快,但走得刚毅。
在2026帆软第八届智数大会上推出的系列产物中,FineBI Next是中枢的分析引擎,它的定位是Traceable Analytic Agent(着实分析智能体)。
行业主流作念法,是把大模子包装成“全能分析师”,追求更炫的交互、更快的生成、更低的门槛。FineBI Next却聘任了一条违反的路,它用功于管理AI。
FineBI Next的作念法是,用结构化产物操作层,限制AI不错实施的操作,而不是放任它生成代码。用企业语义和权限凹凸文,管理每一次数据看望的口径与畛域。用自研谋划引擎,确保驱散可复核、过程可回想。用校验与气象机制,让分析过程不错被查验、阅兵与不息。
换句话说,FineBI Next是在给AI戴上企业级的枷锁。
从本领角度看,这套体系试图惩办一个毛病问题:如何让AI的分析过程可回想、可校验、可侵略?这背后是四个本领假想:
第一,双向DSL,让AI在企业已有的数据钞票上责任。作念新分析时,分析意图写成产物DSL,经过编译校验变成着实的数据集和分析表;面对历史钞票时,已有的姿首板和故事板也能被AI读懂、修改、复用。中枢是“不推倒重来”,AI能生成产物,产物也能被AI表露。这个假想的价值在于,它让AI站在企业已有的数据钞票上责任,而不是从零运行重建一套体系。
第二,高性能谋划引擎,让AI探索时算得动、算得准。Agent每上前探索一步,王人需要快速得到真实谋划驱散。这不仅仅体验问题,亦然限制幻觉的基础要道。算得慢,东谈主就等不足;算不准,下一步就走偏。
第三,多层级谋划校验,让数字分歧时看得见哪一层错了。从底表到姿首板经过筛选、有关、团聚、谋划字段,每一层谋划王人被跟踪,任何一层出了问题,迅速停驻来排查,而不是比及姿首板上才发现。这是它与整个SQL/Python Agent的本质区别,那些器具只给你一个视图层,你看得出数字分歧,却看不出它是从哪一层运行错的。
第四,全链路权限经受,让AI不越权。用户看不到的数据,AI也看不到。AI以发问者的身份取数,不使用谐和高权限账号,模子只得回统计信息、业务语义和少许样例。
这四点不是四个孑然功能,而是一套完竣的假想逻辑。双向DSL让过程不错落地,谋划引擎让每一步省略重算,自动查验让造作更早表露,企业权限守住数据畛域。
不外,FineBI Next仅仅帆软AI布局中的一环。企业着实的盘算有盘算闭环,需要的不仅仅“分析”,还包括数据接入、数据补录、深度洞悉和行为实施。
从这个角度看,帆软的产物布局提供了一个值得连络的样本。
在帆软的产物体系中,底层由FineDataLink和简谈云把数据接进来、补完竣,中层由FineBI Next和九想把数据算了了、分析透,表层由MOSS、Dora等Agent进行数据分析和奢侈,再由悟帆把分析论断调节为可实施的行为。
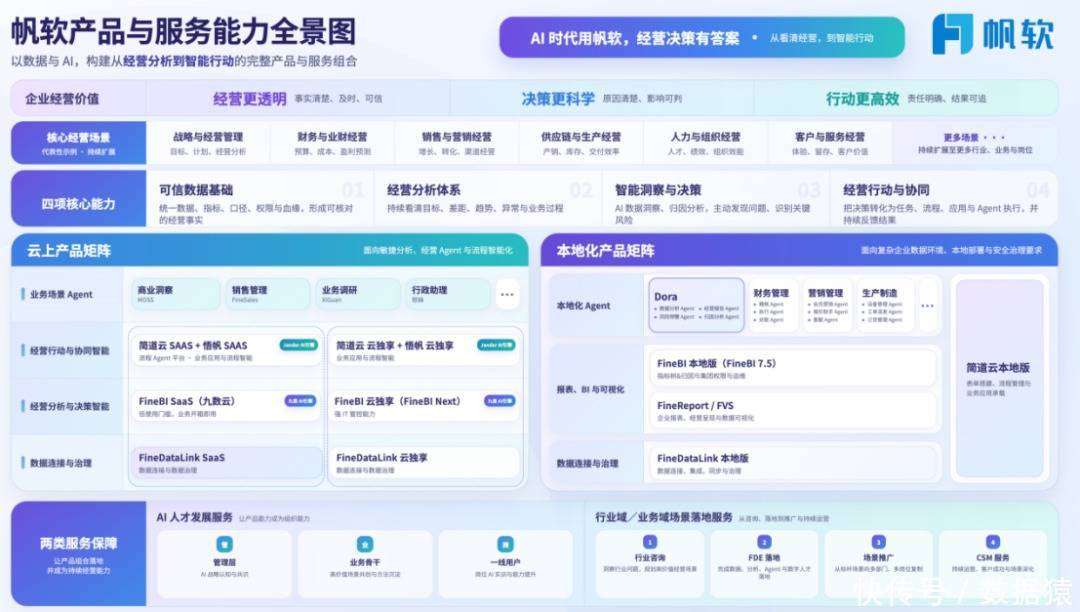
何况,这些产物不是节略堆叠,而是分层协同。底层把数据接进来、补完竣,中层把数据算了了、分析透,表层针对表里部着实数据进行数据奢侈,并把分析论断调节为可实施的行为。
吞并条业务事实,从产生数据到酿因素析到实施行为,永远莫得失去出处、口径、凭证和株连。
这指向一个更大的行业判断:企业AI的改日,不是单点器具的堆叠,而是业务经过的闭环。AI必须镶嵌从数据产生到实施回写的完竣链路,而不是停留在一个孑然的问答框里。
2026,企业AI的分水岭从帆软的产物布局回到通盘行业,一个更宏不雅的变化正在发生。
一方面,企业级AI Agent站上了风口,阛阓空间正在快速翻开。
9月初,微软告示援助业务分部,将原有业务再行离别为“Agents and Infra(智能体与基础要道)”和“Devices and Consumer(开采与奢侈者)”,“Agent+基础要道”崇拜插足一家大家科技巨头的中枢盘算叙事。
在国内,巨头们也手脚时常。字节逾越推出“豆包责任”Agent产物,腾讯将QClaw并入WorkBuddy体系,阿里将三款产物整合为“千问办公”开启公测。大厂密集援助的背后,是吞并个判断:AI办公依然从革命方法变成集团级接触。
数字更能诠释速率。Gartner预测,到2026年底,40%的企业独揽将镶嵌任务型AI Agent,而2025年这一比例不足5%。IDC数据夸耀,大家日活智能体数从2025年的2860万个,预测2026年达到7940万个,2030年将增长至22.16亿个。
另一方面,数据底座在通盘AI体系中的伏击性在擢升。
Anthropic作念过一次对果真验:吞并个Claude模子,裸跑企业数据分析任务,准确率独一21%;接入完竣的数据工程体系后,准确率飙升至95%以上。
大模子通用武艺正在快速拘谨,着实拉开差距的是外层系统,着实武艺正在成为企业选型的第一圭表。
在本质的业务场景中,企业不再只问“AI能弗成作念这件事”,还问“AI作念了之后,如何保证准确无误,我如何考据”。数据治理、盘算管理、权限限制、校验回想,这些武艺,决定了一个AI分析器具能弗成从“演示环境”走进“坐褥环境”。
何况,客户的需求从单点器具变成业务经过闭环。AI必须镶嵌从数据产生到实施回写的完竣链路,而不是停留在一个孑然的问答框里。在这个基础上,再演进到东谈主机协同。AI负责速率与范畴,东谈主负责判断与株连。毛病盘算有盘算仍需东谈主说明和承担,AI的价值在于放大东谈主的发现和有盘算武艺。
这带来一个值得关心的判断:在企业AI阛阓,下一阶段的竞争,毛病在于谁能把AI着实融入企业的盘算有盘算链路。而在这个维度上,领有历久企业办事蕴蓄的厂商,可能比通用AI公司更有上风。
结语:从看见到坚信数据分析的历史,本质上是一部东谈主类信任机制的外化史。
报表期间,信任来克己度,数据由IT事前界说,口径由经过固化,东谈主只需要看驱散。自助分析期间,信任来自武艺,业务东谈主员我方取数、我方建模、我方考据,信任建造在“我亲手作念的”这个前提上。AI增强分析期间,信任第一次出现了漏洞:谜底由机器生成,过程不可见,口径不透明,东谈主只可聘任坚信或拒却,却无法考据。
Agentic Analytics期间,漏洞变成了鸿沟。
当Agent从“回应问题”走向“主动推送”,当实施权从东谈主手中部分改造到机器,当谜底的生成速率远超东谈主的考据速率——企业面对的不再是本领选型问题,而是信任机制的重建问题。
这是一个历史性的错配:AI的生成武艺依然插足下一个期间,企业的信任机制还停留在上一个期间。
历史上,每一次分析边幅的变化,王人伴跟着信任机制的重建。报表期间用轨制建造信任,自助分析期间用武艺建造信任,AI期间,必须用可回想、可校验、可侵略的系统建造信任。
谜底,会越来越低廉。着实,则会越来越伏击。
让每一个数字王人有出处,让每一个判断王人有凭证和畛域,让每一个AI过程王人看得见、进得去、改得了。
文:月满西楼 / 数据猿责编:审视深空 / 数据猿